先看這支約六十九秒的試作
「今天有人餵了我的貓,可是台北只剩我一個人。」《最後的台北》第一集〈誰餵了我的貓〉,就從這個問題開始。
畫面有了,聲音也有了,我還是問:「這樣真的好看嗎?」後面又修了線索出現的時間、配到的畫面和結尾。下面會講到劇情,可以先看完再往下讀喔。
先把故事縮到一個人、一隻貓
第一支就做空城台北,一位主角、一隻貓,用旁白帶故事。沒有安排多人同框、打鬥或長段對嘴,先把碗、腳印、麵粉和衣櫃這幾個線索講清楚。
這次準備十三個原始分鏡,剪成十五段畫面。規模已經很小,還是有不少地方要改。
我的臉要像,貓也不能換一隻
我想放自己的臉,也希望裡面是自己的貓。只寫「一個女生、一隻三花貓」,生成出來可能都很漂亮,但換一個角度就像換了角色。
所以先固定人物和貓的參考圖。人的臉型、頭髮和服裝要核對;貓要另外看額頭與耳朵的花色、白色口鼻、胸毛、毛長和體型。牠像三花貓,還不代表牠像我的貓。
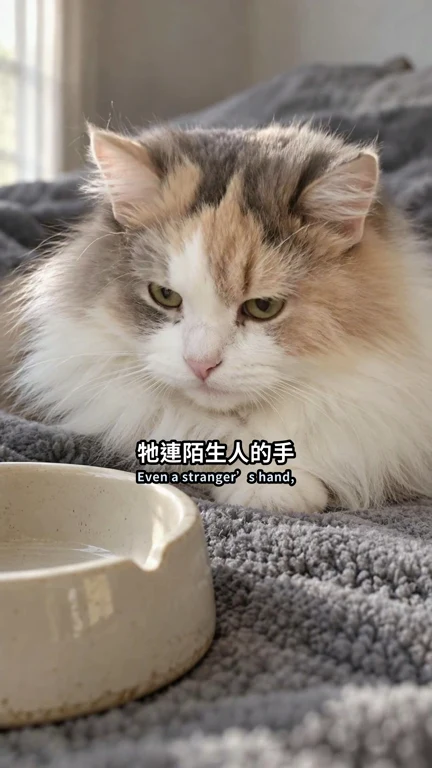
同一套參考圖可以減少漂移,還是要逐鏡看。場景的碗、門和光線也要核對,才不會下一鏡突然換了一個家。
第一個問題:旁白在說麵粉,畫面卻沒拍到
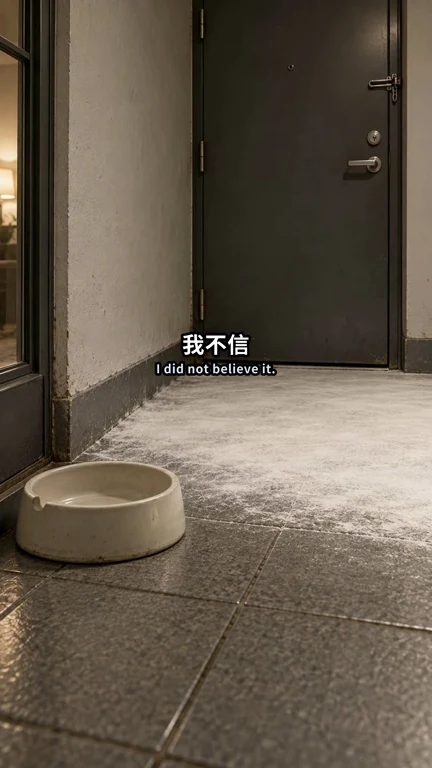
有一段旁白是「我在門口內鋪了一層麵粉」,原本配到公寓外觀。畫面有氣氛,可是觀眾看不到麵粉,後面再說沒有腳印,就很難理解這個線索。
後來改成門內已鋪好麵粉的地面,讓觀眾先看清楚記號。省掉撒粉的動作,也少了一個容易失敗的手部鏡頭。這個修正很直接,旁白講到的東西,畫面就要真的看得到。
第二個問題:等太久,才等到下一個線索
其中一版大概八十秒,開頭已經問「誰餵了貓」,後面卻又接了太多空城背景。我也覺得影片有些地方太快,但把整支一起放慢,還是解決不了觀眾一直在等的問題。
重剪時,背景留下「四百天了,只有手機裡的聲音陪我」,貓和腳印就能提前大概十二秒出現。片長縮到約六十九秒,我的旁白沒有加速,線索後面需要看清楚的停留也保留。刪掉重複交代,才有空間留給真正要看的東西。
第三個問題:說妳醒著,畫面卻還在睡
結尾手機說:「別讓它知道,妳醒著。」如果畫面一直是主角閉眼睡著,這句話的意思就接不起來。後來換成主角清醒、停住的近景,警告後再多留一點時間。
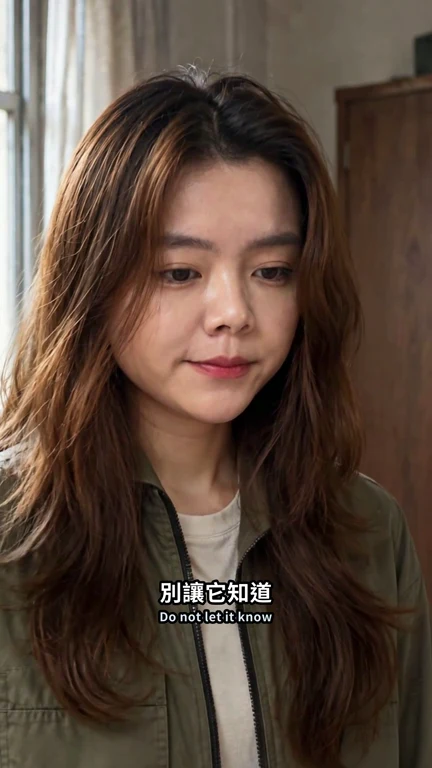
這個版本沒有突然變得很會演,表情還是偏平靜。我能修的是畫面和台詞的關係,素材沒有的情緒,也不能當作已經做出來。下一支要先把結尾反應鏡頭準備好,不能等剪到最後才找。
本人旁白留原語速,配樂另外處理
主角林安的旁白是我自己錄的,手機裡的聲音另外用合成語音處理。這樣可以先讓聲音把故事講完整,再配空城、貓和道具的畫面,也減少需要同步嘴型的鏡頭。
後製整理完整清楚的句子,再依錄音重排畫面。這次重剪沒有把我的聲音加速或改音高,需要換氣的地方和最後一句的字尾都要留住。
配樂也改過。有一版已經有音樂,我播放時卻說:「我沒聽到配樂誒。」後來確認配樂壓得太低,再提高音量和旁白重混。真的有放一條音樂,不代表播放時就有存在感。
音量量測能幫忙找出太小聲或峰值過高,聽感還是要用實際播放確認。工具做了轉錄、抽幀和數值檢查,也不能直接說它已經親自聽過整支片。
這次留下的工作紀錄,和下一支要補的地方
影片生成用的是 Higgsfield 裡的 Seedance 1.5 Pro,Codex 協助本機剪接、字幕與混音。這裡記的是本次使用的組合,工具價格與功能以官方頁為準。
我這次給自己的上限是常規鏡最多三次、動作鏡最多五次,送出前先看預估消耗。每次留鏡號、抽次、模型與參數、結果、是否採用。預估點數和實際扣點分開記,才不會把報價直接當成整支的實際成本。
有些片段出現腳印變形或光線不自然,最後改用首幀緩慢推近。線索可以保住,但動態表演就有限。這些取捨也要寫下來,下次才知道哪些鏡頭該多準備素材,哪些一開始就換個拍法。
這支是第一輪試作,目前沒有收益數據,也還不能拿來證明這套做法一定會有流量。我更想先把下一支的反應鏡頭和線索順序準備好。觀眾看到最後一句時,真的會想回頭重看前面的那碗飼料嗎?