先看重點
- 原理是三層疊起來:原本的影片墊在最底,字卡放中間,再把去背後的人疊回最上面,人就會把字擋住。
- HyperFrames 用一行
remove-background指令就能把人切出來,第一次執行會自動下載大約 168MB 的人像模型。 - 拍的時候鏡頭固定、背景素色、頭頂留空間,這三件事比事後怎麼修都有用。
- 跟 Claude 開工時,先要分鏡表和靜態截圖,位置確認了再做 3 秒試跑,最後才輸出整支。
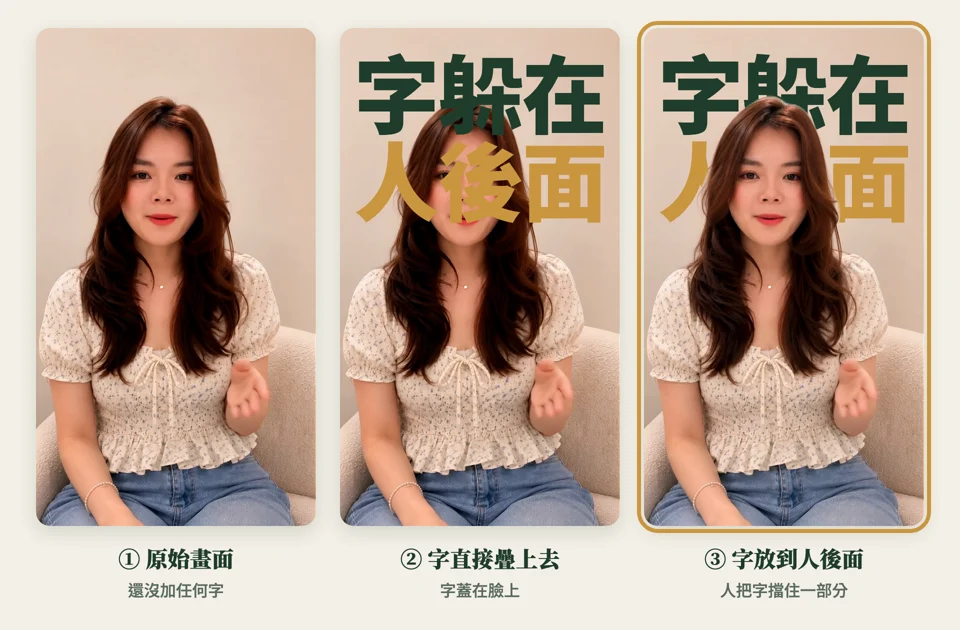
這種效果大家應該都滑過。講話的人在前面,一行很大的字從背後冒出來,頭髮擋住字的一角,畫面一下子就有雜誌封面的感覺。以前要做,得在剪輯軟體裡一格一格描人的邊,或是先去背,再自己一個字一個字對時間,光想就累。
我平常讓 Claude 剪口播,用的是 HyperFrames 這套開源工具。轉逐字稿、去背、排字卡動畫到輸出 MP4,它都包在同一套指令裡,Claude 讀得懂也改得動,拿來做這招剛好順手。所以我把這招的流程整理成可以照著走的版本,提示詞也寫好了,複製改一改就能用。更多剪輯、特效跟動畫的做法,我都放在 AI 分身 × AI 剪輯課裡,文章中間有介紹。
當然,CapCut 也有自動去背,只做一兩支的話,直接用 CapCut 可能更快。交給 Claude 的好處在後面:字卡會照逐字稿自動對到講話的時間,哪一場不滿意講一句話就能重來,一個月要出很多支口播的人會省力很多。
上面那張對照圖,是我拿自己影片裡的一格畫面,實際跑 HyperFrames 的去背做出來的。我寫這篇時對照的是 HyperFrames 0.8 版的官方說明(2026 年 10 月),這套工具更新很快,之後有變動的話以官方為準。
原理其實就是三層疊起來
先把原理弄懂,後面要改的時候,才知道該動哪一層。
最底層是你原本的影片,完整、有背景的那支。中間那層是字卡,大字、數字、關鍵字都放這裡。最上面再疊一層「只有人」的影片,也就是把背景挖掉、只留下人的去背版。人在最上面,字經過人的位置就會被擋住,看起來像字躲在人後面;字跑到旁邊沒有人的地方,又會完整露出來。
去背版的影片,是 AI 模型一格一格判斷「哪裡是人」,再把其他地方變透明。HyperFrames 用的是 u2net_human_seg 這個專門抓人像的模型,Apache 2.0 授權,輸出的透明影片預設是 WebM 格式,HyperFrames 可以直接拿來疊。
還有一個進階做法。HyperFrames 可以一次輸出兩支影片,一支只有人,一支只有背景、人的位置挖空,字卡夾在兩支中間,效果一樣,只是不用再墊原始影片。一般用第一種就夠了,知道有這個選項就好。
開拍前先顧好這三件事
這段我覺得是整篇最重要的。拍壞的素材,後面怎麼調都很辛苦。
鏡頭固定。手持會晃,人的位置一直在變,字一下被擋太多、一下整排露出來,效果很不穩。用腳架或靠著東西放好,整支都不要動。
背景素色,而且跟頭髮、衣服有反差。去背模型最怕頭髮跟背景顏色太接近,像深色頭髮配深色沙發,邊緣就容易被吃掉或一直閃。一面淺色的牆或素色窗簾最保險。
頭頂留空間。這個我自己踩過。第一次我拿一格頭頂幾乎貼著畫面上緣的畫面試,字放在上半部,結果整排被頭髮吃掉,只剩兩邊露出一點點,根本看不出是什麼字。換成頭頂有留白的那一格,字才露得出來,就是上面對照圖那張。拍的時候,頭頂上方至少要留得下一行大字。
另外,手勢也會擋字。比手畫腳沒關係,但重點字出現的那幾秒,手盡量不要舉到臉旁邊。用 iPhone 拍的話還有一個顏色的坑,我放到後面常見問題講。
要準備的工具
Claude Code 要先裝好,電腦還要有 Node.js 22 以上跟 FFmpeg。接著把 HyperFrames 裝進 Claude Code,下面這行貼到終端機執行,或直接請 Claude Code 幫你跑都可以。裝完把 Claude Code 關掉重開,它就知道怎麼用 HyperFrames 做影片:
npx skills add heygen-com/hyperframes --yes如果你是第一次裝這些東西,我之前寫過一篇 Video-use 加 HyperFrames 的自動剪輯教學,環境怎麼補、哪裡最容易卡,那篇講得比較細,這裡就不重複了。
去背的部分不用另外裝。第一次執行去背指令時,HyperFrames 會自己裝好需要的套件,再下載大約 168MB 的人像模型,之後就不用再下載。Apple 晶片的 Mac 會自動用 CoreML 加速,有 NVIDIA 顯示卡的話可以另外設定 CUDA,都沒有就用 CPU 跑,只是比較慢。第一次跑會等比較久,看起來有點像當機,中間 Claude Code 也會跳出來問能不能執行指令,按允許就好。
我在 Mac 上拿一張 1080×1920 的直式畫面測,模型載入之後,整張去背大約半秒就跑完。不過影片一秒有二三十格,一分鐘的片子就有一千多格,每一格都要算,片子越長等越久。所以後面我會建議先拿 3 秒試跑,片子長的話,也可以請 Claude 放在背景慢慢跑。
第一段提示詞:先要分鏡,不要直接要成品
工具裝好之後,把影片放進一個新資料夾,檔名改成短一點的英文,例如 talk.mp4,路徑有中文或空格有時候會出錯。然後在那個資料夾打開 Claude Code,用終端機的話先 cd 到那個資料夾再輸入 claude,用桌面版的話開新對話時選那個資料夾。接著貼這段:
這個資料夾有一支直式口播影片 talk.mp4,我想用 HyperFrames 做成「字躲在人後面」的版本:原影片墊底,字卡放中間,去背後的人疊在最上面。

先不要輸出整支影片,請照順序做:
1. 用 ffprobe 告訴我片長、尺寸、幀率,確認有聲音。如果是 iPhone 的 HDR 影片,先轉成 SDR;如果是變動幀率,照原本的每秒格數轉成固定幀率。有轉檔的話,之後去背跟合成都用轉好的那支。
2. 轉逐字稿,影片是中文,請用多語言模型並指定中文。轉完把人名、產品名、數字列出來讓我核對。
3. 從逐字稿挑 4 到 6 個值得做成字卡的詞,排成分鏡表:第幾秒出現、放哪裡、怎麼進場出場、要不要躲在人後面。
4. 每一場輸出一張靜態截圖給我看,然後停下來等我。

規則:
- 字可以被人擋住一部分,但重點字至少要露出一半,不能蓋到臉
- 字卡在講到那個詞的時候才出現,不要提早
- 字卡一律用繁體中文,字型用 Noto Sans TC,字型檔放進專案資料夾
- 畫面最下面跟最右邊留給 IG 的字幕和按鈕,不放字卡
- 分鏡確認後,先只做前 3 秒的試跑影片給我看
這段提示詞有幾個地方是刻意寫的。
第一個是轉逐字稿要講明是中文。HyperFrames 轉逐字稿預設用的是英文專用模型,中文影片直接丟進去,出來的是英文翻譯,中文字卡根本挑不出來。寫清楚「中文」,Claude 就會換成多語言模型。
第二個是叫它先停下來。分鏡表跟截圖看起來像多一道手續,但整支影片算一次要花不少時間,算完才發現字蓋到臉,那才真的白等。先看截圖,位置不對改一句話就好。截圖會存在資料夾裡,也可以請它開預覽網頁,直接在瀏覽器看。
第三個是規定哪裡不能放字。手機上看短影音,最下面有字幕跟說明文字,右邊有愛心、留言那排按鈕,字卡放在那裡會被平台介面蓋住,你在電腦上看不出來,上傳之後才會發現。
去背這一步,Claude 在背後做什麼?
這段寫給想知道原理的人,不想看可以直接跳過,Claude 會自己處理。
去背的核心就是下面這行,把 talk.mp4 裡的人切出來,存成透明背景的 subject.webm:
npx hyperframes remove-background talk.mp4 -o subject.webm --quality best--quality 有 fast、balanced、best 三段,預設是 balanced。它調的是去背影片壓縮得多細,去背判斷本身的精準度不會因此改變。這招是把人疊回原本的影片上,壓得越省,人的邊緣越容易出現色差或一圈光暈,所以正式輸出建議用 best,試跑的時候用預設就好。
還有兩個地方很容易弄錯,如果你看到人跟背景對不齊,或人在某個瞬間閃一下,可以直接提醒 Claude。
一個是兩支影片要從同一個時間點開始播。去背版如果設定成晚幾秒才出現,播放時很容易差一格,看起來就是人跟背景錯開了。比較穩的做法是兩支都從第 0 秒一起播,要它晚點出現,就先把它藏起來,時間到了再顯示。
另一個是淡入淡出要調外面那層。想讓去背的人淡入淡出,要把影片包在一個外框裡,調外框的透明度。HyperFrames 會強制正在播放的影片保持不透明,直接調影片本身,畫面不會有任何反應。
看截圖怎麼改:每次只改一件事
截圖出來,通常會有幾個地方不滿意,這很正常。改的時候講清楚是第幾秒,一次只改一件事,最後再補一句其他地方不要動。不然它很容易順手把你本來喜歡的地方也改掉。
像這樣講就很清楚:
第 4 到 6 秒的「三倍」太小了,放大到畫面寬度八成左右,其他場不要動。

第 9 秒的字幾乎被頭整個擋住,往右上移,至少要露出一半,其他場不要動。

人的邊緣跟原片有一點色差,像多了一圈光暈,重做去背這一步,品質改用 best。

字卡太多了,刪掉第 3 場跟第 5 場,只留數字跟結論那幾場。
截圖跟試跑影片要分開看。截圖只看得出位置,像字有沒有蓋到臉、會不會被平台的按鈕擋住;人的邊緣會不會閃、字有沒有跟上講話、聲音跟嘴型對不對得上,要等試跑影片動起來才看得出來。截圖很漂亮,不代表動起來也沒問題喔。
都確定之後,跟它說「前面都確認了,輸出整支,用最高品質」。輸出完先拿手機從頭看一遍,小字糊不糊、字卡有沒有被擋到,在手機上看真的比在電腦上準很多。
常見翻車與處理方式
字整排不見了?
最常見的原因是被人整個擋住了,字剛好放在頭的正後方,或是人在那幾秒移了過去。把字往人的旁邊或上方移,讓重點字至少露出一半。真的沒有空間的話,這一場就讓字放在人前面,不是每一場都要躲。
人的邊緣一直閃?
去背是一格一格判斷的,頭髮細、背景跟頭髮顏色接近、光線忽明忽暗,邊緣就容易每一格長得不一樣,播起來像在閃。最有效的是重拍時換一面跟頭髮有反差的背景。不想重拍的話,就讓字不要貼著頭髮邊緣經過,閃的地方會比較不明顯。我那張對照圖放大來看,頭頂髮絲跟字的交界也有一圈淡淡的亮邊,在我那張圖裡,深綠色字比金色字明顯。
iPhone 拍的影片,做完整個偏灰?
這個我自己也遇過。iPhone 預設會用 HDR 錄影,直接拿去剪,顏色常常變得又灰又淡。開工前跟 Claude 說「這支是 iPhone 拍的,先檢查是不是 HDR,是的話先轉成一般 SDR 再做」,它會用 FFmpeg 轉好。也可以到 iPhone 的「設定」,點「相機」再點「錄影」,把「HDR 影片」關掉,之後拍的就不會有這個問題。
聲音跟嘴型越到後面越對不上?
手機錄的影片多半是變動幀率,每秒的格數不固定。後製時如果被當成固定幀率處理,就會越到後面差越多。開工前請 Claude「照原本的每秒格數,例如 30fps,轉成固定幀率再開始做」,前面那段提示詞第 1 步已經寫進去了。
中文字變成一格一格的方框?
電腦裡沒有可用的中文字型,或字型沒有一起打包進專案。跟 Claude 指定一套中文字型,並請它把字型檔放進專案資料夾裡,換一台電腦輸出也不會跑掉。
最後提醒:別讓每一場都躲
這招以前最花時間的部分,是描邊跟對時間,現在交給 Claude 跟 HyperFrames,幾乎不用自己動手。可是字要放哪、哪幾個詞值得做成字卡、這一場要不要躲,還是得你自己看截圖決定。
我會建議別每一場都躲。一支三十秒左右的片子,字從人背後冒出來兩三次就夠亮了,每一句都這樣,看的人只會覺得畫面很吵吧。
那你的下一支口播,最想讓哪一句話從背後冒出來呢?
更多剪輯、特效跟動畫,都在這堂課裡。
看 AI 分身 × AI 剪輯課