先看重點
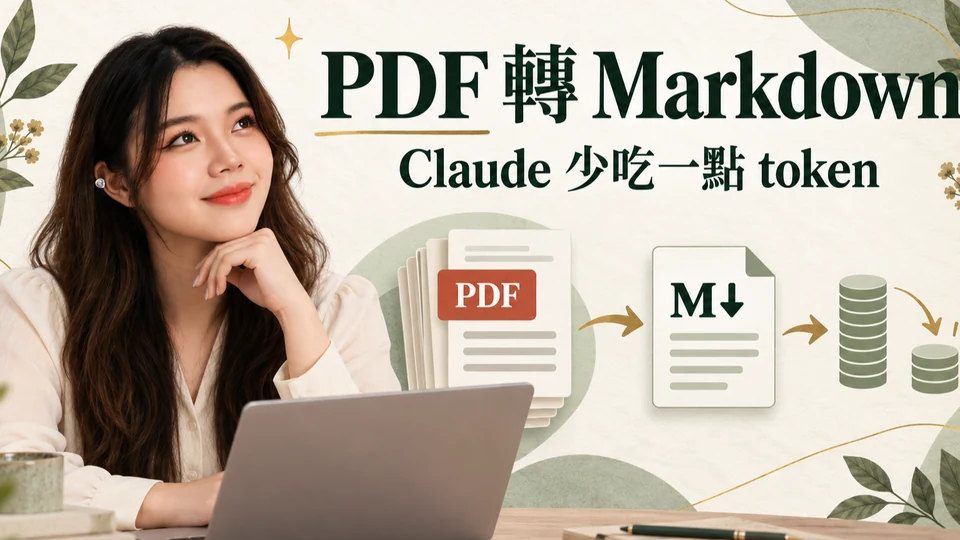
- Claude 讀 PDF 的方式是每頁轉成一張圖片,再把該頁文字一起送進去,等於同一頁被處理兩次。
- 官方文件寫得很清楚:文字部分每頁大約 1500 到 3000 token,整頁圖片的視覺 token 還要另外算。
- MarkItDown 是微軟開源的免費工具,把檔案轉成 Markdown 之後,圖片那一份就不必付了。
坦白說,我一開始完全沒意識到這件事。工作檔案就是 PDF,要問 Claude 就是直接拖進去,用了大半年都沒想過中間發生什麼。後來是有一次我連丟幾份企劃書,額度掉得莫名其妙的快,才回頭去翻官方文件,然後就看到那一段。
這篇是我查證完之後的整理:Claude 到底怎麼讀 PDF、為什麼特別貴、微軟的 MarkItDown 怎麼裝怎麼用,還有我自己拿一份真的企劃書跑出來的結果。順便也講不該轉的情況,因為這個工具不是萬用的。文中的官方說法都對照過 Anthropic 的 PDF 支援文件 與 MarkItDown 的 GitHub 專案頁,查證日期是 2026 年 9 月 19 日,之後若有變動以官方說明為準。
Claude 讀 PDF 的時候,其實讀了兩次
Anthropic 官方的 PDF 支援文件把流程寫得很白:它會把每一頁拍成一張圖,再把那頁抽出來的字,連著那張圖一起送給模型。兩份都送,不會只挑一種。
因為有整頁圖片,Claude 才看得懂你那張長條圖在比什麼、表格的欄位怎麼對齊、簽名蓋在哪一格。純抽文字的話,這些視覺訊息會整個消失。真的需要看版面的時候,這個機制很好用。
代價是成本。官方的成本估算寫著,文字的部分每頁通常吃掉大約 1500 到 3000 token,內容越密越多。圖片那一份要另外算:每 28×28 像素算一個視覺 token,標準級的模型一張圖最多 1568 個,你現在用的如果是 4.7 之後的高解析度模型,上限直接拉到 4784 個。
把數字疊起來就很有感覺了。一份三十頁的 PDF,光文字就可能吃掉四萬五到九萬 token,再加上三十張整頁圖片。結果你只是想問其中某一頁的一句話。
限制也順便記一下:單次請求最大 32MB,最多 600 頁,模型的脈絡長度如果低於 1M,就只能 100 頁。官方也有提醒,很密的 PDF 常常還沒碰到頁數上限,脈絡就先被塞滿了。
MarkItDown 是什麼?
MarkItDown 是微軟放在 GitHub 上的開源工具,MIT 授權,免費,本體是一個很輕的 Python 套件。它的說明寫著自己是「把各種檔案轉成 Markdown、給 LLM 與文字分析流程使用」的小工具,理由也講得直接:主流的大型語言模型天生就會讀 Markdown,同樣的內容,Markdown 換算成 token 比較省,又能保住標題、清單、表格這些結構。
它不是 AI,不會幫你摘要,也不會潤稿。它就是一個安靜的轉換器,把你的檔案變成 Claude 最好讀的那種樣子。
官方列出來支援的格式包含 PDF、Word、PowerPoint、Excel、圖片(讀 EXIF 與 OCR)、音訊(讀 EXIF 與語音轉錄)、HTML、CSV、JSON、XML、ZIP 壓縮檔、EPub,以及 YouTube 連結。我自己最常用到的是 PDF 跟 PowerPoint,再來是 Excel。
安裝:一行指令
前提是電腦裡要先有 Python。有了之後,打開終端機(Windows 是命令提示字元或 PowerShell),輸入這行:
pip install "markitdown[all]"方括號那段是把所有格式的支援一起裝起來,省得之後轉某個檔案才發現少東西。裝完之後,轉檔是這樣:
markitdown 你的檔案.pdf > 你的檔案.md同一個資料夾就會多出一個 .md 檔,拖進 Claude 就可以問了。想指定輸出位置的話,也可以用 -o:
markitdown 你的檔案.pdf -o 想要的檔名.md三種接法,看你懶到什麼程度
第一種,命令列轉完再上傳。就是上面那兩行。最笨但最穩,臨時要處理一兩份檔案的時候我都用這個,不用設定任何東西。
第二種,寫進 Python 流程。如果你本來就有在跑自動化,把它接在讀檔那一段就好:
from markitdown import MarkItDown

md = MarkItDown()
result = md.convert("test.xlsx")
print(result.markdown)
第三種,用 MCP 接進 Claude Desktop。官方 repo 裡有一個 markitdown-mcp 套件,設定成 MCP 伺服器之後,就能在對話裡直接叫它轉檔,不用切出去開終端機。想先搞懂 Claude Desktop 跟 MCP 是什麼的話,可以搭配 Claude Desktop 下載與安裝教學 看。
實際轉一份 15 頁企劃書看看
我拿自己手邊一份 15 頁的中文企劃書 PDF 跑了一次,轉出來的 Markdown 全文大約 7300 個字元,中文字大概 4400 個,平均一頁三百個中文字上下。這份檔案是簡報型的,版面大、字不多,所以轉完之後小得很誇張。
對照一下官方的算法。這 15 頁走 PDF 的路,除了抽出來的那些字,還要再付 15 張整頁圖片:標準級的模型一張最多 1568 個視覺 token,15 張就是兩萬三上下;4.7 之後的高解析度模型一張最多 4784 個,15 張逼近七萬二。文字那一份兩邊都要付,省掉的是圖片這整筆。
所以省多少要看你用哪一級的模型。標準級的話,省掉的是每頁那 1568 個視覺 token,換算下來大約三到五成;4.7 之後的高解析度模型,一張整頁圖就吃到 4784 個,省的幅度會拉到六到八成。我這份簡報因為字特別少,比例又更高。反過來說,整頁密密麻麻的純文字報告,文字那一份佔得重,省的比例就掉下來。
什麼時候不要轉
這個工具我用得很開心,但它確實有不適合的場合,這些我覺得比省 token 更該先講。
版面本身就是資訊的時候。設計稿、有複雜合併儲存格的報表、流程圖、簽核單,這些東西的意義有一半在排版裡。轉成純文字之後,Claude 只會看到一堆脫節的字串,答案反而會變差。這種檔案我就直接丟 PDF,寧可花那個 token。
掃描檔跟拍照檔。這類 PDF 裡面根本沒有文字層,抽不出東西來。要嘛走 OCR,要嘛就讓 Claude 用看圖的方式讀,硬轉只會得到一個空檔案。
你要問的就是圖表。「這張圖的趨勢在說什麼」這種問題,本來就是要模型去看那張圖。把圖拿掉再問,等於自己把答案藏起來。
所以我的實際做法是分流:文字為主的長檔案先轉,版面為主或要看圖的直接丟原檔。判斷不出來的時候,兩邊各問一次,看哪邊的回答比較準,通常一次就知道了。
省下來的額度可以拿去做什麼
講到最後其實不只是省錢的問題。同一個脈絡長度裡,塞進去的東西越乾淨,模型能一次看完的內容就越多。原本一次只塞得下一份報告,轉完之後可以一次丟三份進去比較,這個差別比帳單上的數字有感多了。
如果你已經在用 Claude 工作,想知道自己這個方案的額度怎麼算,可以接著看 Claude 訂閱價格:台灣實付與最省買法;想讓它照你的習慣做事,則可以看 Claude Skills 教學。
MarkItDown 常見問題
MarkItDown 是什麼?
微軟開源的 Python 小工具,MIT 授權,免費。工作只有一件:把各種檔案轉成 Markdown 純文字,專門給大型語言模型讀。它不是 AI,不會摘要也不會潤稿。
MarkItDown 支援哪些格式?
官方列出的有 PDF、Word、PowerPoint、Excel、圖片(讀 EXIF 與 OCR)、音訊(讀 EXIF 與語音轉錄)、HTML、CSV、JSON、XML、ZIP、EPub,還有 YouTube 連結。
MarkItDown 怎麼安裝?
電腦先要有 Python,然後在終端機輸入 pip install "markitdown[all]"。轉檔輸入 markitdown 檔名.pdf > 檔名.md,同一個資料夾就會多一個 .md 檔。
轉成 Markdown 真的能省 token 嗎?
會省,但幅度看模型跟文件。Claude 讀 PDF 是每頁轉成圖片再加上該頁文字,文字每頁大約 1500 到 3000 token,圖片另計;轉成 Markdown 之後圖片那份就不見了。標準級的模型大約省三到五成,4.7 之後的高解析度模型一張整頁圖上限 4784 個視覺 token,省的幅度會到六到八成。
MarkItDown 可以直接接進 Claude 嗎?
可以。官方 repo 有 markitdown-mcp 套件,設定成 Claude Desktop 的 MCP 伺服器之後就能在對話裡直接轉檔。不想碰設定的話,先用命令列轉好再上傳一樣有效。
結語:先看一眼檔案再決定怎麼丟
這個工具的門檻真的很低,一行指令就裝完了,但它逼你問一個比較有用的問題:你丟給 AI 的東西,有多少是它真的需要讀的?我自己開始分流之後,帳單只是順便,真正的改變是我會先看一眼檔案,想想這份要問的是文字還是版面。
那你這個月丟進去的檔案裡面,有幾份其實只要文字就夠了呢?
想把這類省成本的做法,整套接進你的工作流程?
預約 AI 工作流諮詢