先看重點
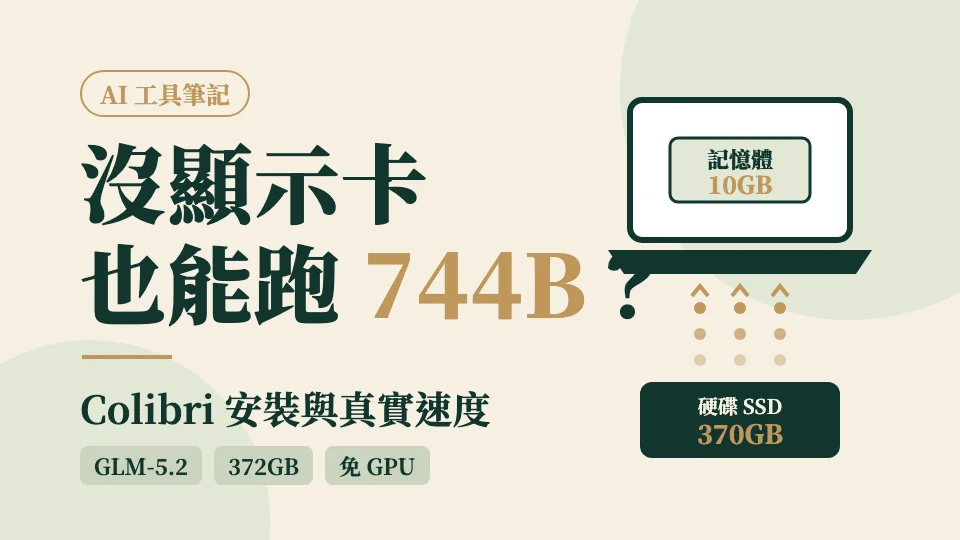
- Colibri 是開源的推論程式,只把 GLM-5.2 大約 10GB 的核心參數放在記憶體,其餘約 370GB 放在硬碟,用到哪一段才讀哪一段。
- 官方寫的需求是記憶體 16GB 起跳、24GB 比較舒服,加上約 372GB 硬碟空間,不需要顯示卡。但官方在 25GB 記憶體的機器上實測,冷啟動每秒只有 0.05 到 0.1 個 token,16GB 的筆電甚至連速度都量不出來。
- 開發者可以用
coli serve在自己電腦開一個跟 OpenAI 相容的 API,對話內容不會離開你的電腦。
如果你是從我 IG 那支影片點進來的,先謝謝你留言。影片只有五十幾秒,很多細節根本講不完,這篇就是我在影片裡說「整理好了」的那份完整資訊。
坦白說,我第一次看到「沒顯示卡的筆電跑 744B」這種標題,直覺是哪裡一定寫錯了。7440 億參數的模型,照一般的做法要一整排高階顯示卡才塞得下。後來我把 Colibri 的 GitHub 說明從頭讀到尾,才發現它沒有騙人,只是標題省略了一個很重要的條件,就是速度。
也先講清楚,我自己的電腦沒有空出 372GB 的位置,所以這篇的速度數字全部引用官方公開的實測,我自己沒有跑過。文中的說法都對照過 Colibri 的 GitHub 專案頁 與它的 API 說明文件,查證日期是 2026 年 9 月 28 日。這個專案更新得很勤,之後若有變動,以官方說明為準。
744B 的模型,為什麼塞得進一台筆電?
關鍵在 GLM-5.2 的架構。它是 Z.ai(智譜)開源的模型,屬於混合專家架構,英文叫 MoE。整個模型有 7440 億個參數,但每產生一個 token,只會叫醒其中大約 400 億個,差不多是全部的百分之五。
既然每次只用到一小部分,Colibri 的做法就是把每次都會用到的留在身邊,其他的放遠一點。注意力層、共用專家這些每個 token 都會經過的部分,壓成 int4 之後大約 9.9GB,常駐在記憶體裡。剩下大約 370GB 的專家參數放在硬碟上,模型需要哪一個,才即時從硬碟讀進來。
我在影片裡用追劇來比喻。串流平台不會先把整部電影下載完才讓你看,它是邊播邊抓下一段。Colibri 也是這個概念,只是它串流的是模型參數,來源是你自己的硬碟。
還有一點我覺得一定要講。官方說明寫得很硬:記憶體不夠只會讓它變慢,不會偷偷降低模型的精度,也不會改掉模型挑選專家的方式。慢歸慢,答出來的東西還是同一個模型答的。
先講最重要的:它真的很慢
這段是影片沒時間講,但我覺得最該講的部分。
官方在說明頁列了不同硬體的實測速度。最低那一檔是 25GB 記憶體的開發機,冷啟動時每秒大約 0.05 到 0.1 個 token。換成白話,大概要十到二十秒才冒出一個 token,差不多就是一個中文字上下。一段一百字左右的中文回答,粗估要等上十幾分鐘到半小時,這還不含它讀你問題的時間。
硬體往上加,速度才會起來。同一張表裡,128GB 記憶體、只用 CPU 的桌機,暖機之後大約每秒 1.8 個 token;一張 RTX 5070 Ti 等級的顯示卡大約每秒 1 個;六張 RTX 5090 全部塞滿,也才每秒 6 個上下。
所以影片裡那句「打臉非得買高檔 GPU 不可的說法」,我要在這裡補完整:沒有顯示卡確實跑得起來,Colibri 把這件事做得比以前完整、也好上手很多;但官方自己也寫了,顯示卡只會讓它更快,而真正決定速度的,是你的硬碟讀得多快。
所以不要急著問「我的筆電跑不跑得動」,只要記憶體夠、硬碟空得出 372GB,大多跑得起來。該先問的是:你願意為一個回答等多久?
你的電腦跑得動嗎?先對這四項
記憶體:官方寫最少 16GB,24GB 比較舒服。常駐的部分大約 9.9GB,多出來的空間拿來當快取,快取越大,回頭讀硬碟的次數就越少。不過官方的效能文件也提到,有人拿 16GB 的筆電實測,連速度都量不出來,因為扣掉常駐的部分,能當快取的空間幾乎不剩。16GB 的機器,官方建議改跑小一點的模型。
硬碟:模型檔大約 372GB,而且速度主要卡在硬碟,最好放在 NVMe 固態硬碟上。傳統硬碟或慢速的外接碟也許能跑,但會慢到很難用。官方還有一招,是把模型複製一份到第二顆固態硬碟,兩顆一起讀,他們在一台機器上實測快了大約 37.5%,但也說不保證每台都有這個效果。
顯示卡:不需要。有的話會變快,沒有也能跑。
作業系統:Linux、macOS、Windows 都有官方打包好的版本(ARM 版的 Linux 要自己從原始碼編譯)。另外要先裝 Python 3,因為啟動器跟 API 的部分是用 Python 寫的,推論引擎本身則是純 C。
安裝:拿程式、拿模型、跑起來
官方把安裝拆成三步。程式本身只有幾百 KB,真正花時間的是下載模型。
第一步,拿程式。最簡單的是到 GitHub 的 Releases 頁面,下載你作業系統對應的壓縮檔,解壓縮就能用,不用自己編譯。想從原始碼裝的話,電腦要有 gcc 跟 OpenMP:
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh
setup.sh 會自己檢查環境、編譯,最後跑一次自我測試。影片裡講的「複製儲存庫,跑個安裝檔」,就是這兩行。
第二步,拿模型。官方推薦的是 Hugging Face 上已經轉好的版本,group-scaled(gs64)的 int4,加上 int8 的 MTP 頭,大約 372GB:
huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp
這裡有個坑要特別提醒喔。網路上還流傳一些比較舊的 int4 版本,官方實測品質差了大約 9 個百分點,也是之前有人遇到模型鬼打牆、回答停不下來的主要原因。下載的時候,認準上面那個連結的完整名稱就好。
第三步,跑起來。把 COLI_MODEL 指到你放模型的資料夾:
COLI_MODEL=/你的路徑/glm52_i4 ./coli chat記憶體要分多少當快取、要不要開加速,它都會自己偵測。第一次用的話,可以先跑 COLI_MODEL=/你的路徑/glm52_i4 ./coli doctor,它會幫你檢查模型檔案齊不齊。不想一直待在終端機的話,./coli web --model /你的路徑/glm52_i4 會開一個網頁介面,用起來比較像一般的聊天視窗。如果打開看到的是錯誤頁,代表網頁介面還沒建置,要先裝 Node.js,再到專案的 web 資料夾執行 npm install 跟 npm run build。
Windows 的話,壓縮檔裡有一個 coli.cmd,雙擊就能開,也可以在命令提示字元輸入 coli.cmd chat --model D:\glm52_i4。
開發者:把它當成 OpenAI API 用
這段寫給會寫程式的朋友。coli serve 會在你的電腦上開一個跟 OpenAI 相容的 API,原本呼叫 OpenAI 的程式,換一個網址就接得過來:
COLI_MODEL=/你的路徑/glm52_i4 COLI_API_KEY=my-local-key ./coli serve \
  --host 127.0.0.1 --port 8000 --model-id glm-5.2-colibri
那組密碼請用英文字母跟數字,放中文的話,程式送出請求時會直接出錯。程式那邊這樣接:
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="my-local-key",
    timeout=3600,
    max_retries=0,
)
resp = client.chat.completions.create(
    model="glm-5.2-colibri",
    messages=[{"role": "user", "content": "你好"}],
)
print(resp.choices[0].message.content)
timeout 跟 max_retries 那兩行很重要。它回一段話可能超過十分鐘,SDK 預設等十分鐘就放棄、還會自動重試,重試的請求又會塞進伺服器的排隊,排超過五分鐘就被退回,反而更慢。
同一個埠也有 Anthropic 格式的 /v1/messages,用 Claude SDK 寫的程式一樣接得上。
兩個現實面也要講。第一,它一次只處理一個請求,同時打進來的會排隊。第二,速度就是前面那幾個數字,拿來做需要即時回應的客服機器人不太實際,比較適合丟著讓它慢慢跑的批次工作,或是資料真的不能離開公司的場合。
至於影片裡說的「token 費用直接歸零」,不用付 API 的錢是真的,但電費、硬碟,還有你等它的時間,也都是成本,這筆帳要自己算喔。
這適合誰?不適合誰?
適合的人,是手邊有一台記憶體大、固態硬碟空間夠的電腦,想親手摸摸頂級開源模型的人;或是資料很敏感,怎樣都不能丟上雲端的團隊;再來就是本來就對推論技術有興趣、想研究它怎麼做到的人。
不適合的人,是想要一個跟 ChatGPT 一樣秒回的日常助手,手上又只有一台普通筆電。你大概會先被 372GB 的下載卡住,接著被速度把耐心磨光。
如果你是後者,但還是想玩玩看,我會建議先從小一點的模型開始。Colibri 同一套指令也能跑其他模型:記憶體有 24GB 的話,可以試 Qwen3.6(350 億參數),轉好的檔案大約 20GB,官方實測只用 CPU 大約每秒 1.4 個 token,加兩張 8GB 的顯示卡可以到每秒 10 個左右;記憶體只有 16GB 的話,可以先試 OLMoE(70 億參數),大約 8GB 記憶體就夠。從原始碼裝的人要注意,每個模型要另外編譯對應的引擎,例如 Qwen3.6 是 make -C c qwen36。先用小模型把流程走熟,再決定要不要清出 372GB 給 GLM-5.2,會比較不容易白忙一場。
Colibri 常見問題
Colibri 是什麼?
開發者 Vincenzo Fornaro 開源的推論程式,Apache 2.0 授權。推論引擎用純 C 寫成、不依賴其他函式庫,啟動器跟 API 則需要 Python 3。它把顯示卡記憶體、電腦記憶體跟硬碟當成同一套儲存層,讓超大的混合專家模型可以在一般硬體上跑。
沒有顯示卡真的能跑 GLM-5.2 嗎?
可以。官方寫的需求是記憶體 16GB 起跳、24GB 比較舒服,加上約 372GB 的硬碟空間,不需要顯示卡。但速度很慢,官方在 25GB 記憶體的機器上實測,冷啟動時每秒大約只產生 0.05 到 0.1 個 token;16GB 的筆電則連速度都量不出來,官方建議改跑小模型。
跑 GLM-5.2 需要多少硬碟跟記憶體?
模型檔約 372GB,最好放在 NVMe 固態硬碟,因為速度主要看硬碟讀取。記憶體官方寫最少 16GB,24GB 比較舒服,但 16GB 的機器實測幾乎跑不動,想跑 GLM-5.2 建議至少 24GB。
這是拿掉安全限制的版本嗎?
不是。Colibri 載入的是 Z.ai 以 MIT 授權釋出的 GLM-5.2 權重,只做了 int4 壓縮,沒有另外修改模型。在自己電腦上跑,少的是雲端服務那一層內容過濾,模型本身受過的安全訓練還在。
用 Colibri 資料真的不會外流嗎?
模型在你自己的電腦上運算,對話內容不會送到別人的伺服器。coli serve 開的 API 預設也只綁在本機 127.0.0.1,要讓其他電腦連進來的話,官方建議先設定 COLI_API_KEY。
Colibri 可以取代 ChatGPT 嗎?
在一般筆電上不建議。它比較適合重視隱私、可以接受慢速的用途,或是記憶體跟固態硬碟都很充裕的機器。想要秒回的日常助手,雲端服務還是比較實際。
結語:它把門檻從顯示卡,搬到了硬碟
這個專案最打動我的地方,是以前想跑頂級模型,得先買一整排顯示卡,現在變成清出一顆硬碟就能開始。這個方向我真的會持續追,說不定再過一陣子,速度就追上來了。
只是在現在這個階段,我會先把它收藏起來當實驗看,還不會拿它換掉每天在用的工作工具。
那你手上想交給 AI 的那件事,比較需要的是快,還是把資料留在自己身邊呢?
想知道本機 AI 能不能接進你的工作流程?
預約 AI 工作流諮詢